开放代码社区 › spark-x
spark-x
AI/机器学习Java基于大语言模型与编排的企业级 AI 智能体开发平台 中文 English 什么是 SparkX? SparkX 是一个采用 大语言模型 + 可视化编排 构建的企业级 AI 智能体开发平台,覆盖从知识库入库、检索增强、智能体对话到工作流编排的完整链路。开箱即用、模型任选、灵活编排。 模型任选 :基于 LangChain4j 统一封装,接入 OpenAI 兼容标准接口,几乎覆盖市面上所有主流大模型——不限于官方服务,也支持 Ollama 等自建模型。
仓库地址
https://gitee.com/shop-sparker/spark-x.gitREADME
<p align="center">
<a href="https://gitee.com/shop-sparker/spark-x">
<img src="https://web-code-img.oss-cn-shanghai.aliyuncs.com/readme/d930c114e42c48ada951f244.png" width="286" />
</a>
</p>
<p align="center">
<strong>基于大语言模型与编排的企业级 AI 智能体开发平台</strong><br/>
</p>
<p align="center">
<a href="https://gitee.com/shop-sparker/spark-x/blob/master/README.md">🇨🇳 中文</a> | <a href="https://gitee.com/shop-sparker/spark-x/blob/master/README.en.md">🇬🇧 English</a>
</p>
<p align="center">
<a href="https://gitee.com/shop-sparker/spark-x/stargazers"><img alt="Gitee stars" src="https://gitee.com/shop-sparker/spark-x/badge/star.svg?theme=gvp" /></a>
<a href="https://gitee.com/shop-sparker/spark-x/members"><img alt="Gitee forks" src="https://gitee.com/shop-sparker/spark-x/badge/fork.svg?theme=gvp" /></a>
<a href="https://gitee.com/shop-sparker/spark-x/blob/master/LICENSE"><img alt="License" src="https://img.shields.io/badge/license-Apache--2.0-4a9b8f?style=flat-square" /></a>
<img src="https://img.shields.io/badge/Spring%20Boot-3.4-6DB33F?style=flat-square&logo=springboot&logoColor=white" />
<img src="https://img.shields.io/badge/LangChain4j-1.18-orange?style=flat-square" />
<img src="https://img.shields.io/badge/Vue-3-42b883?style=flat-square&logo=vuedotjs&logoColor=white" />
</p>
## 🚀 什么是 SparkX?
SparkX 是一个采用 **大语言模型 + 可视化编排** 构建的企业级 AI 智能体开发平台,覆盖从知识库入库、检索增强、智能体对话到工作流编排的完整链路。开箱即用、模型任选、灵活编排。
- **模型任选**:基于 `LangChain4j` 统一封装,接入 OpenAI 兼容标准接口,几乎覆盖市面上所有主流大模型——不限于官方服务,也支持 Ollama 等自建模型。
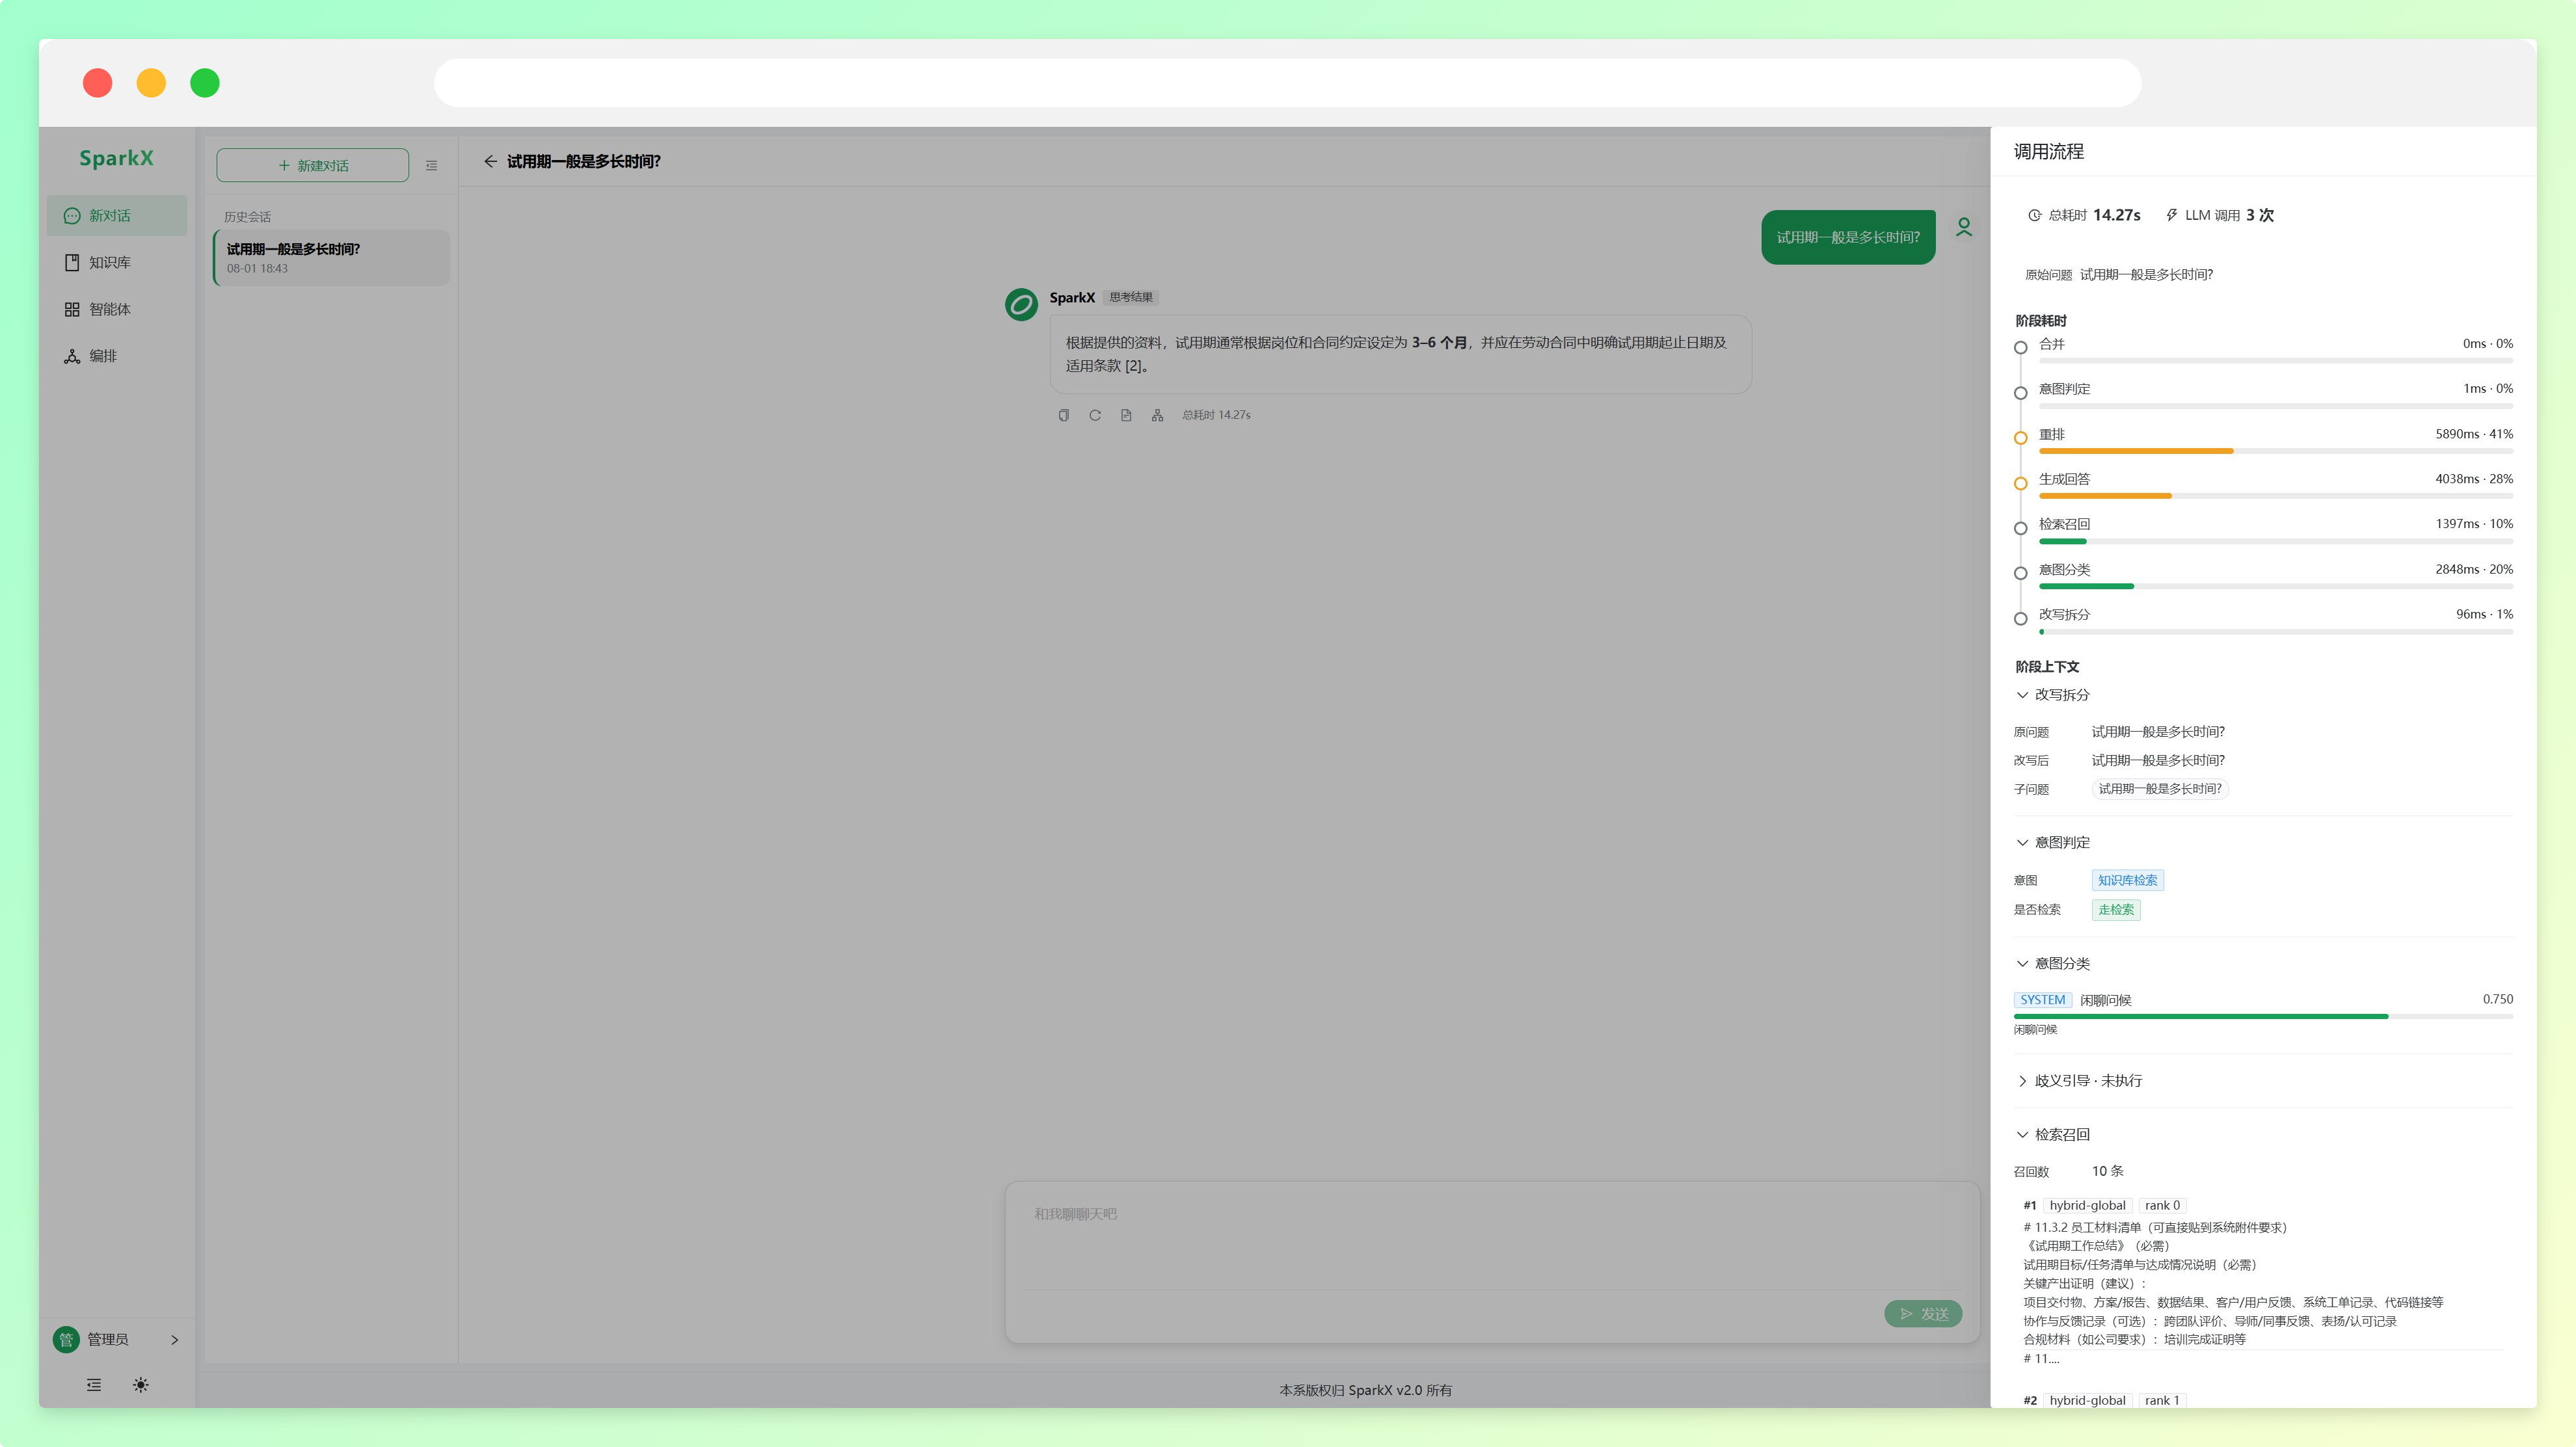
- **RAG 索引增强**:自研多路检索管线,向量 + 关键词混合检索,多通道 RRF 融合 + 父子分块扩展 + MMR 去冗余 + 重排精排,有效消除大模型幻觉,对私有数据问答尤为有效。
- **知识图谱增强**:原生集成 `Neo4j` 知识图谱,文档入库时自动抽取实体与关系;检索支持「实体子图扩展(1~2 跳)」「社区摘要」多模式,并与向量检索 RRF 融合,把分散在多文档间的关联串起来,擅长回答「A 与 B 有何关系」「列出所有 X」这类问题。
- **意图理解 & 智能路由**:内置可配置的意图树(`t_intent_node`),规则快速路径零成本判定问候 / 闲聊,低温 LLM 精准归类到业务节点(KB / SYSTEM / MCP 三类);检索前先路由,歧义问题自动引导澄清,把不该走知识库的问题前置拦截。
- **样例记忆命中**:高频 / 标准问题可预先写入样例库(`sample_query`),用户提问向量命中即零 LLM 直返答案,典型问题不再消耗推理资源,进一步降本提速。
- **会话记忆**:双层记忆抗长对话 token 爆炸——L1 滑动窗口保留最近 N 轮原样消息,L2 话题摘要把更早的对话压缩成话题索引(只记话题不记答案,防与实时检索冲突),多轮追问上下文不断、token 不爆。
- **灵活编排**:基于 `AntV X6` 可视化流程引擎,让多个 Agent 按节点图协同工作,覆盖单轮问答无法承载的复杂业务场景。
- **模型容错**:多模型路由 + 三态熔断器 + 首包探测 + 优先级降级链,单个模型供应商故障不影响业务。
- **MCP 无限扩展**:原生集成 MCP 协议(langchain4j-mcp),让 AI 自由调用外部业务工具,能力无上限。
一句话:**生产落地智能体会踩的坑,这里都有对应方案**。一套经过真实场景锤炼的工程实践,系统覆盖 RAG / Agent / MCP / 编排等核心能力。
## 🧭 快速导航
> 觉得不错?先点个 Star 收藏 👇
| | 链接 | 说明 |
|:---:|:---|:---|
| 📖 | <a href="https://x.sparkshop.cn/" target="_blank">使用手册</a> | SparkX 完整使用文档 |
| 🚀 | <a href="#-快速开始" target="_blank">快速开始</a> | Docker 一键启动前后端 |
| 💡 | <a href="#-为什么需要-sparkx" target="_blank">为什么需要 SparkX</a> | 设计思考与价值 |
| 🏗️ | <a href="#-sparkx-核心设计" target="_blank">核心设计</a> | 架构与工程实践 |
---
## 💡 为什么需要 SparkX?
AI 这波浪潮,企业已经躲不过去了。
不管是客服、运营、还是内部 IT,都在想办法把大模型接进自己的业务。但真正动手时会发现:调个 API 容易,做出一个**能上线、能扛住生产流量、能持续运营**的智能体系统,坑多到怀疑人生。
### 企业落地 AI 智能体的 3 个真实痛点
### 1. 模型不稳定,挂了怎么办?
线上不可能只依赖一个模型供应商。网络抖动、限流、服务降级随时发生。如果系统只接了一家,它一挂,整个智能体就哑火。
SparkX 的做法是:**多候选路由 + 三态熔断 + 自动降级**。一个模型挂了,自动切到下一个候选,配合首包探测保证切换对用户无感知。
### 2. 知识库问答不准,幻觉满天飞
直接把原始文档塞给模型,回答质量看天吃饭。用户问"报销流程",模型可能给你编一个不存在的流程。
真正的 RAG 系统要考虑:文档怎么切分最合理?混合检索怎么融合排序?召回结果怎么去重精排?上下文怎么压缩不超 Token?每一环都是工程决策。
### 3. 单轮问答不够用,复杂场景怎么搞?
很多业务不是一问一答能解决的——查订单要带用户信息、走审批要调多个接口、处理工单要按步骤来。单纯的 RAG 智能体搞不定。
SparkX 提供了**可视化工作流编排**,把多个节点串成图,让 AI 按流程协同工作,而不是只会一问一答。
## 🏗️ SparkX 核心设计
采用前后端分离架构。后端按职责划分模块,知识库(RAG)子系统自包含,移植自经过生产验证的 sparkxV2。
```
spark-x/
├── admin/ # Vue3 + Naive UI 管理后台(智能体/知识库/AI配置/编排/对话调试)
├── server/ # Spring Boot 3.4 后端(包根 sparkx.sparkshop)
└── docker/ # 一键编排(backend + frontend + PgSQL + Redis + MinIO)
```
后端核心模块:
| 模块 | 职责 |
|---|---|
| `knowledge/` | 知识库 / RAG / 智能体子系统(自包含,最大模块) |
| `workflow/` | 工作流编排引擎(可视化节点图执行) |
| `evaluation/` | 评测(意图分类评估面板) |
| `system/` | 系统模块(用户/鉴权/通用) |
| `common/` | 通用基础设施(config / exception / utils) |
> 分层不是为了炫技,而是解决实际问题:`knowledge` 子系统内部进一步按 pipeline / retrieval / ingest / infra / mcp / intent / graph 分包,换模型供应商不用改业务代码,加检索通道不用动生成逻辑。
<details>
<summary><b>knowledge 模块完整结构(点击展开)</b> · 后端最大子系统,RAG / 智能体 / 意图 / 图谱 / MCP 全部自包含于此</summary>
### 目录结构
```
knowledge/
├── pipeline/ # RAG 流水线引擎(按 @Order 自动装配)
│ └── stages/ # 11 个具体阶段(样例/改写/意图/检索/重排/生成…)
├── retrieval/ # 检索通道 + 后处理链(混合 / 去重 / MMR / RRF 融合)
├── ingest/ # 文档入库流水线(解析 / 分块 / 嵌入 / 索引)
│ ├── block/ # 基于版面的结构化分块(段落 / 标题 / 表格 / 代码…)
│ └── mineru/ # MinerU 复杂版面解析客户端封装
├── intent/ # 意图树 + 规则快路径 + LLM 分类 + 引导澄清
├── graph/ # 知识图谱(Neo4j 存储 + 抽取 + 检索通道)
├── infra/ # LLM / 嵌入 / 重排 基础设施
│ ├── chat/ # 模型客户端(路由 + 三态熔断 + 首包探测 + 流式)
│ └── model/ # 模型健康 / 路由选择 / 路由执行
├── mcp/ # MCP 工具注册中心 + 执行器
├── memory/ # 对话记忆(历史加载 + 摘要压缩)
├── agent/ # 智能体对话编排入口 + 评测
├── prompt/ # 提示词编排(场景路由 + 模板管理)
├── query/ # 查询改写 / 扩展 / 多子问题拆分
├── fallback/ # 模型兜底 / 降级策略
├── config/ # Spring Bean 装配与配置绑定
├── controller/ # REST 入口(各领域 HTTP 接口)
├── service/ + impl/ # 业务逻辑层(接口 + 实现)
├── mapper/ # MyBatis Mapper(各表 CRUD)
├── entity/ # 持久化实体(对应 26 张业务表)
├── vo/ # 出入参 DTO
├── validate/ # 入参校验(每场景一个 Validate 类)
└── common/ # 异常 + 全链路 Trace AOP
├── exception/ # RAG 统一异常
└── trace/ # @RagTraceNode 链路追踪切面
```
### 各目录职责
**流水线核心**
- `pipeline/` — `RagPipeline` 按 `@Order` 自动装配所有 stage;`PipelineStage` 定义 `CONTINUE` / `FALLBACK` / `COMPLETE` 契约;`PipelineContext` 贯穿各阶段共享上下文。
- `pipeline/stages/` — 11 个阶段:样例命中(5) → 改写拆分(10) → 意图分类(20/30) → 歧义澄清(40) → 引导(50) → 检索(60) → 重排(70) → 合并(80) → 生成(90);任一步可短路 `COMPLETE` 直返,异常走 `FallbackStage` 兜底。
**检索**
- `retrieval/` — `ConditionalRetrievalChannel` 接口 + `VectorKeywordHybridChannel`(向量+关键词)、`IntentDirectedChannel`(意图驱动);`HybridContentRetriever` 编排多通道;后处理链 `Deduplic